
mlab-LLM
2026/10/16研究室でゼロから学習した日本語LLM
mlab-LLMは、既存モデルに頼らず日本語テキストを用いてスクラッチ(ゼロから)で事前学習を行った小規模言語モデルである。学習は研究室内の単一GPU(RTX 4090 1枚)で実施し、約7日間で完了させた。最終的には、本モデルを研究室のWebサイト上で案内や質問対応を行うチャットボットとして実用化することを目指している。
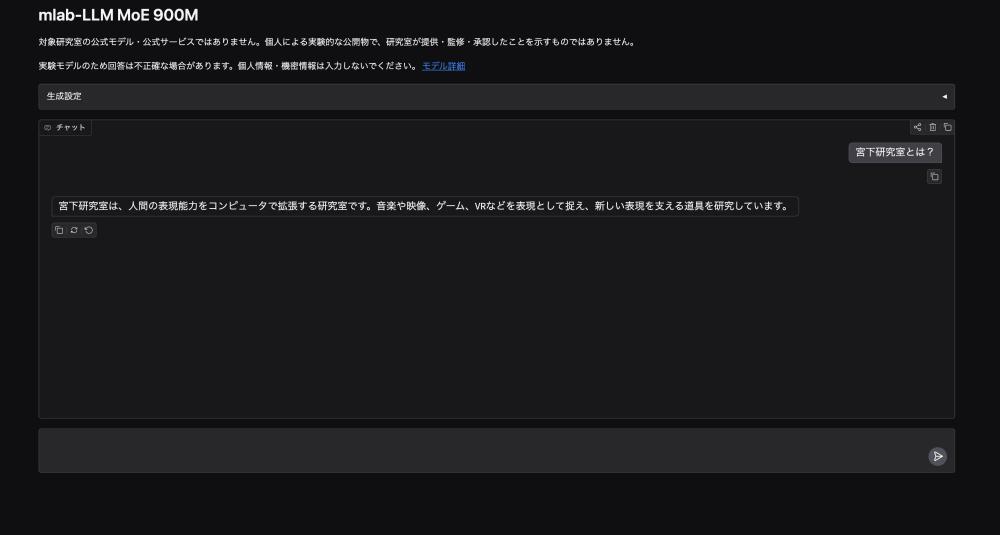
構築手順としては、まず約3億パラメータ(300M)のベースモデルを日本語Webテキストで事前学習した。続いて一般的な対話データおよび研究室固有のQ&Aデータを用いて追加学習(ファインチューニング)を行い、その後、モデルの表現力向上を目的にMixture of Experts(MoE)構造へと拡張した。MoEを採用することで、入力に応じて動作する「エキスパート」ネットワークを切り替え、計算量を抑えつつモデル容量を拡大し、研究室に関する知識の保持力を高めている。
学習したモデルはHugging Faceで公開している(MoE 900M、300M Base、ブラウザ向けONNX版)。
使用言語
Python
タグ
#LLM#機械学習#AI